Epub-audiobook项目介绍
将一本epub格式的电子书,变成有声音频。先从文本解析说话人、然后对不同的说话人指定不同的音色,让你喜欢的声音给你读书。
本文档是对epub-audiobook项目的介绍,从软件设计的角度,介绍从epub电子书合成有声书音频的过程。
依赖
- gpt-sovits:默认且目前只支持的TTS引擎,依赖其本地推理及音声克隆能力
- ffmpeg:音频拼接、转码能力
- 线上或本地大模型api(任意):用于推理文本中的说话人
- node环境:项目本身是运行在node环境中的http服务,前端web界面及所有后端功能
核心概念
本节讲解软件设计的核心概念“台词表”、“音频参考”、以及对应关系,方便读者理解架构和界面
台词表
台词表是epub文件经过文本切分、LLM标注之后生成的一个JSON文件,同一个epub可以生成多个台词表
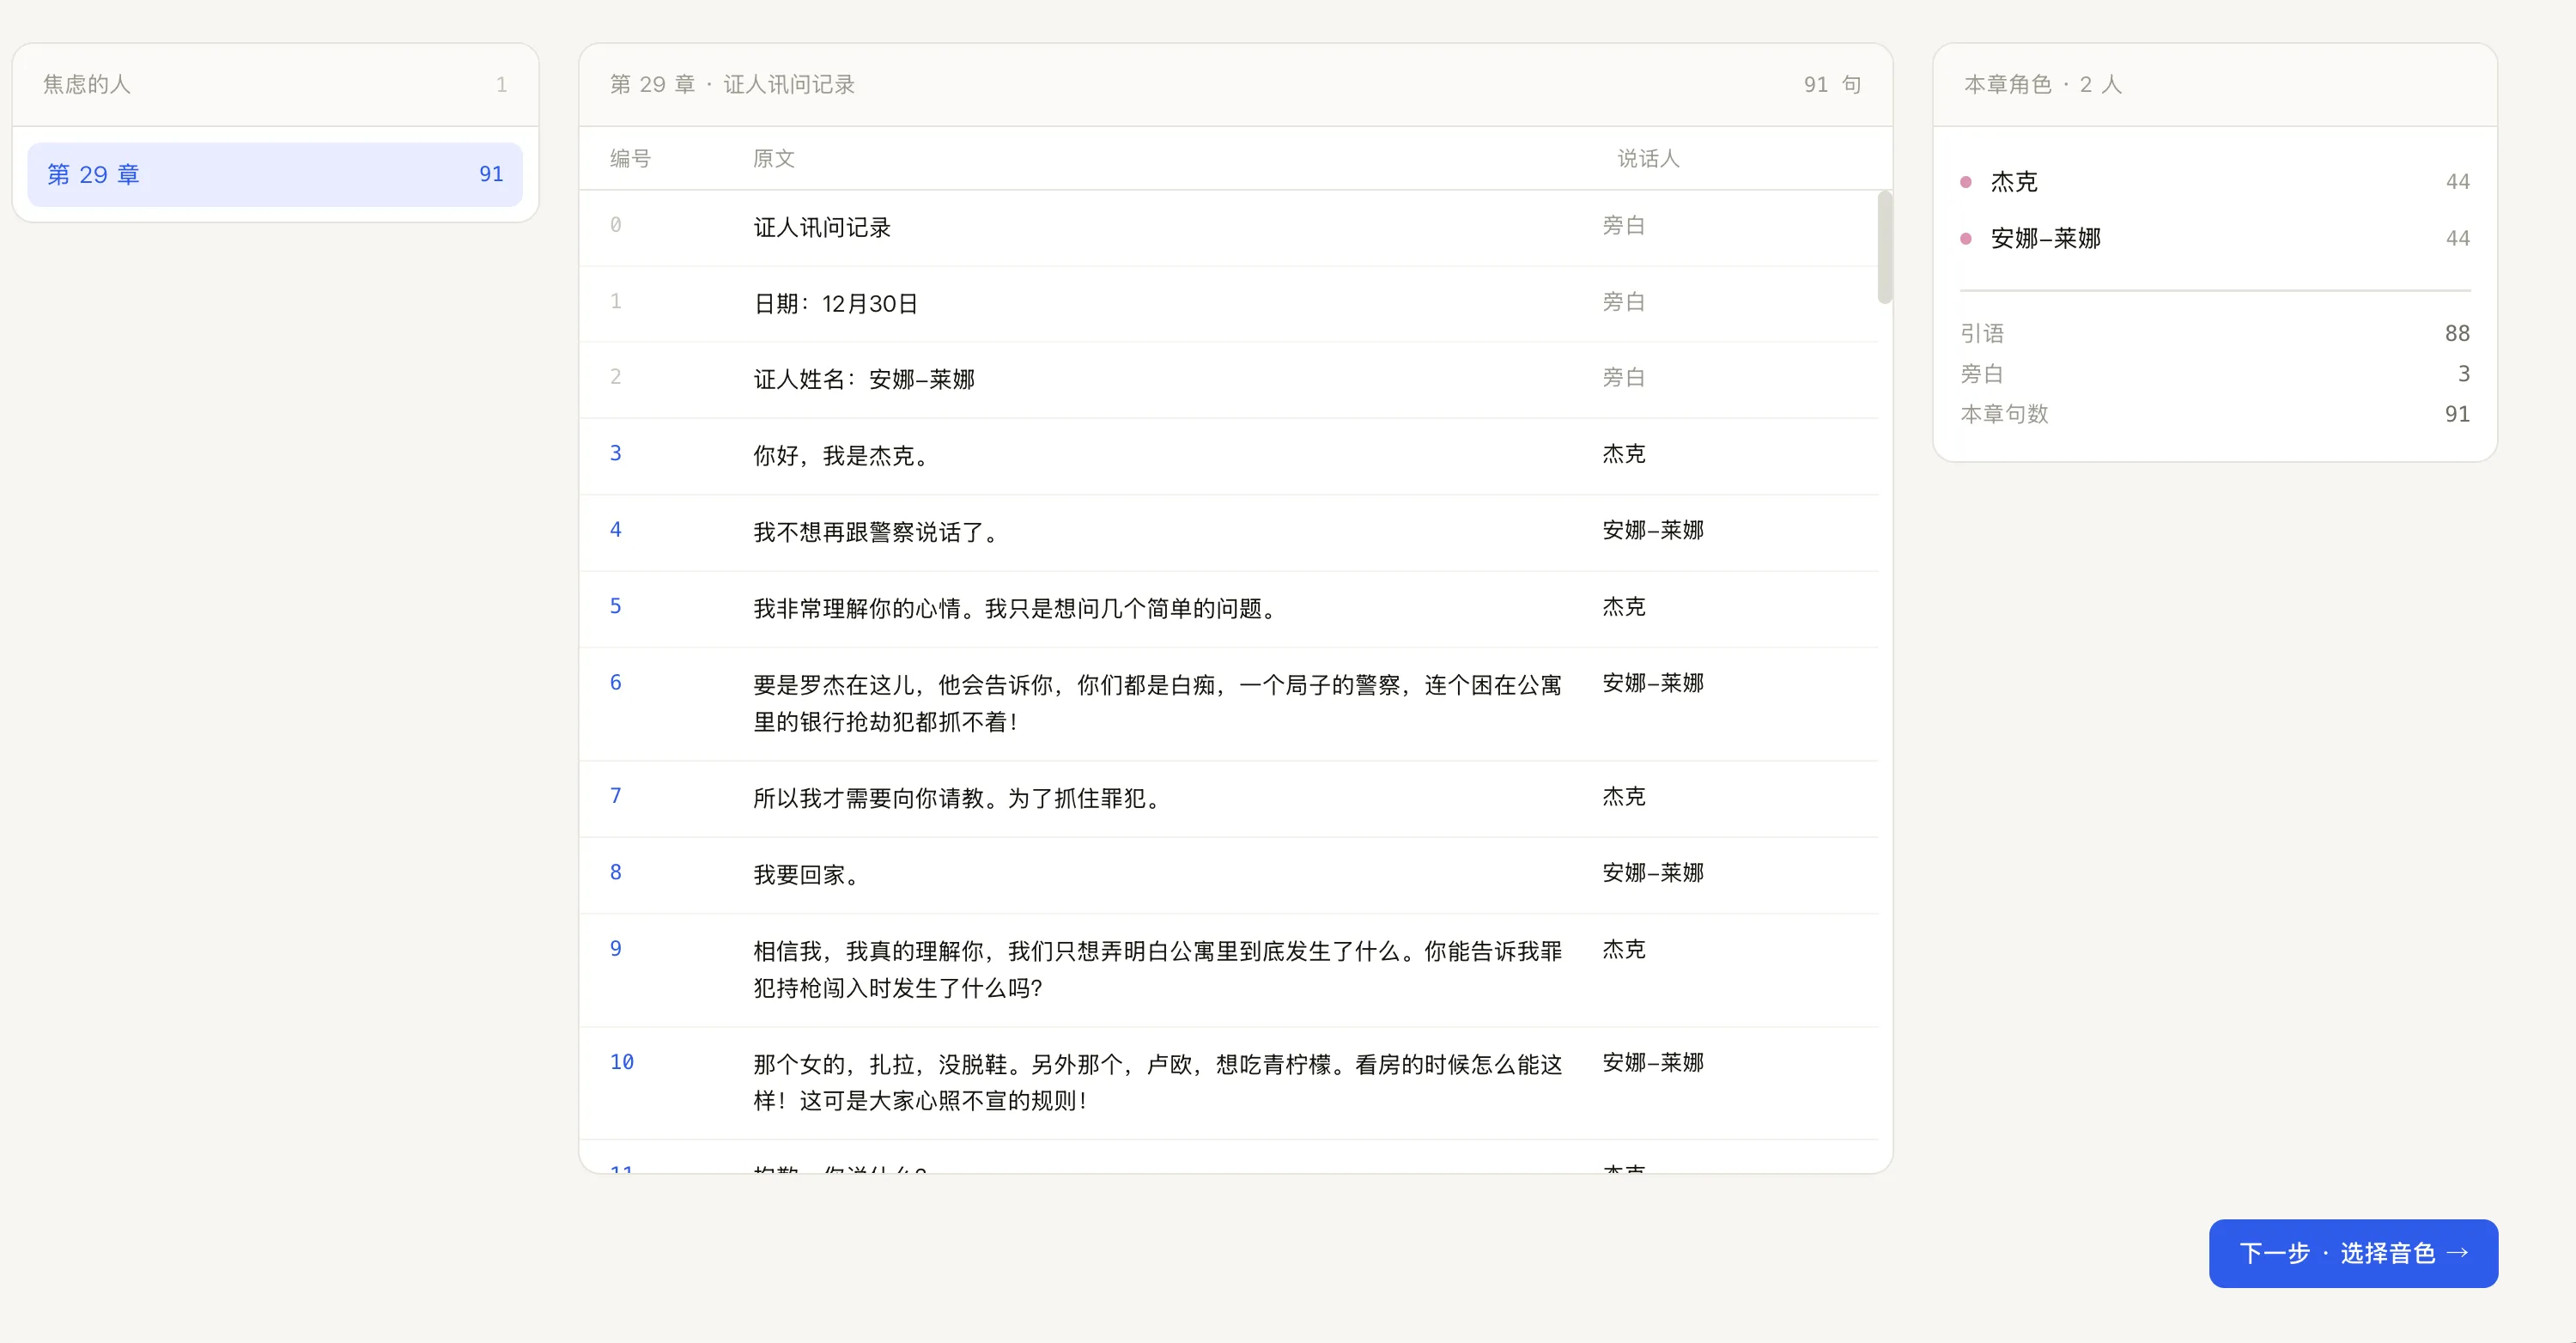
上图是台词表在项目中的可视化展示,包含、章节范围(章节粒度对齐epub文件)、以及文本-说话人的对应关系、以及全量说话人列表。
音频参考
用户自备的音声文件,用来喂给gpt-sovits引擎,配音时模仿语气。在合成音声产物时,需要用户对台词表中每一个说话人分配一个音频参考。
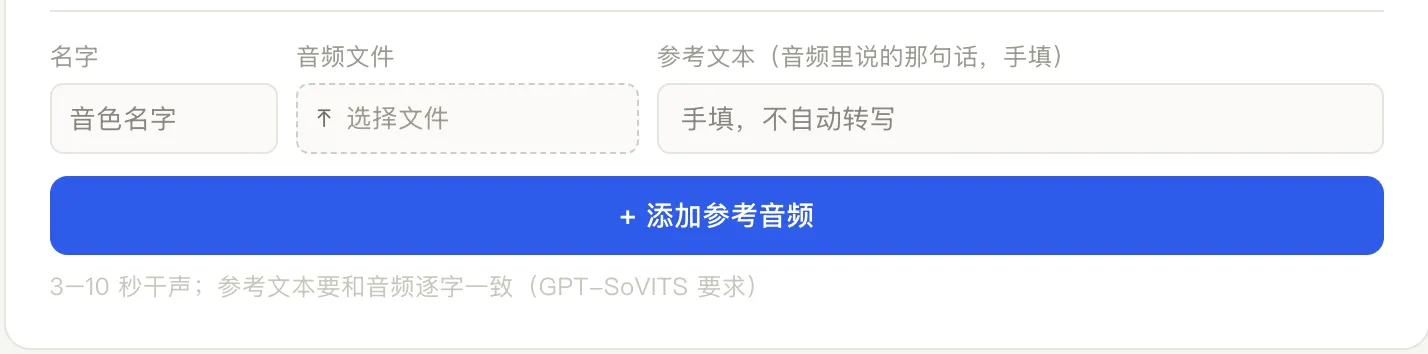
上图是单条音频参考的结构,包含名称、文件路径、参考音频的文本内容。
音频产物
音频产物则是台词表,在指定配音规则下,生成的音频文件,一个台词表可以合成若干个音频产物,一章(粒度对齐epub文件)对应一个mp3文件,最终合成产物。
架构
实现原理
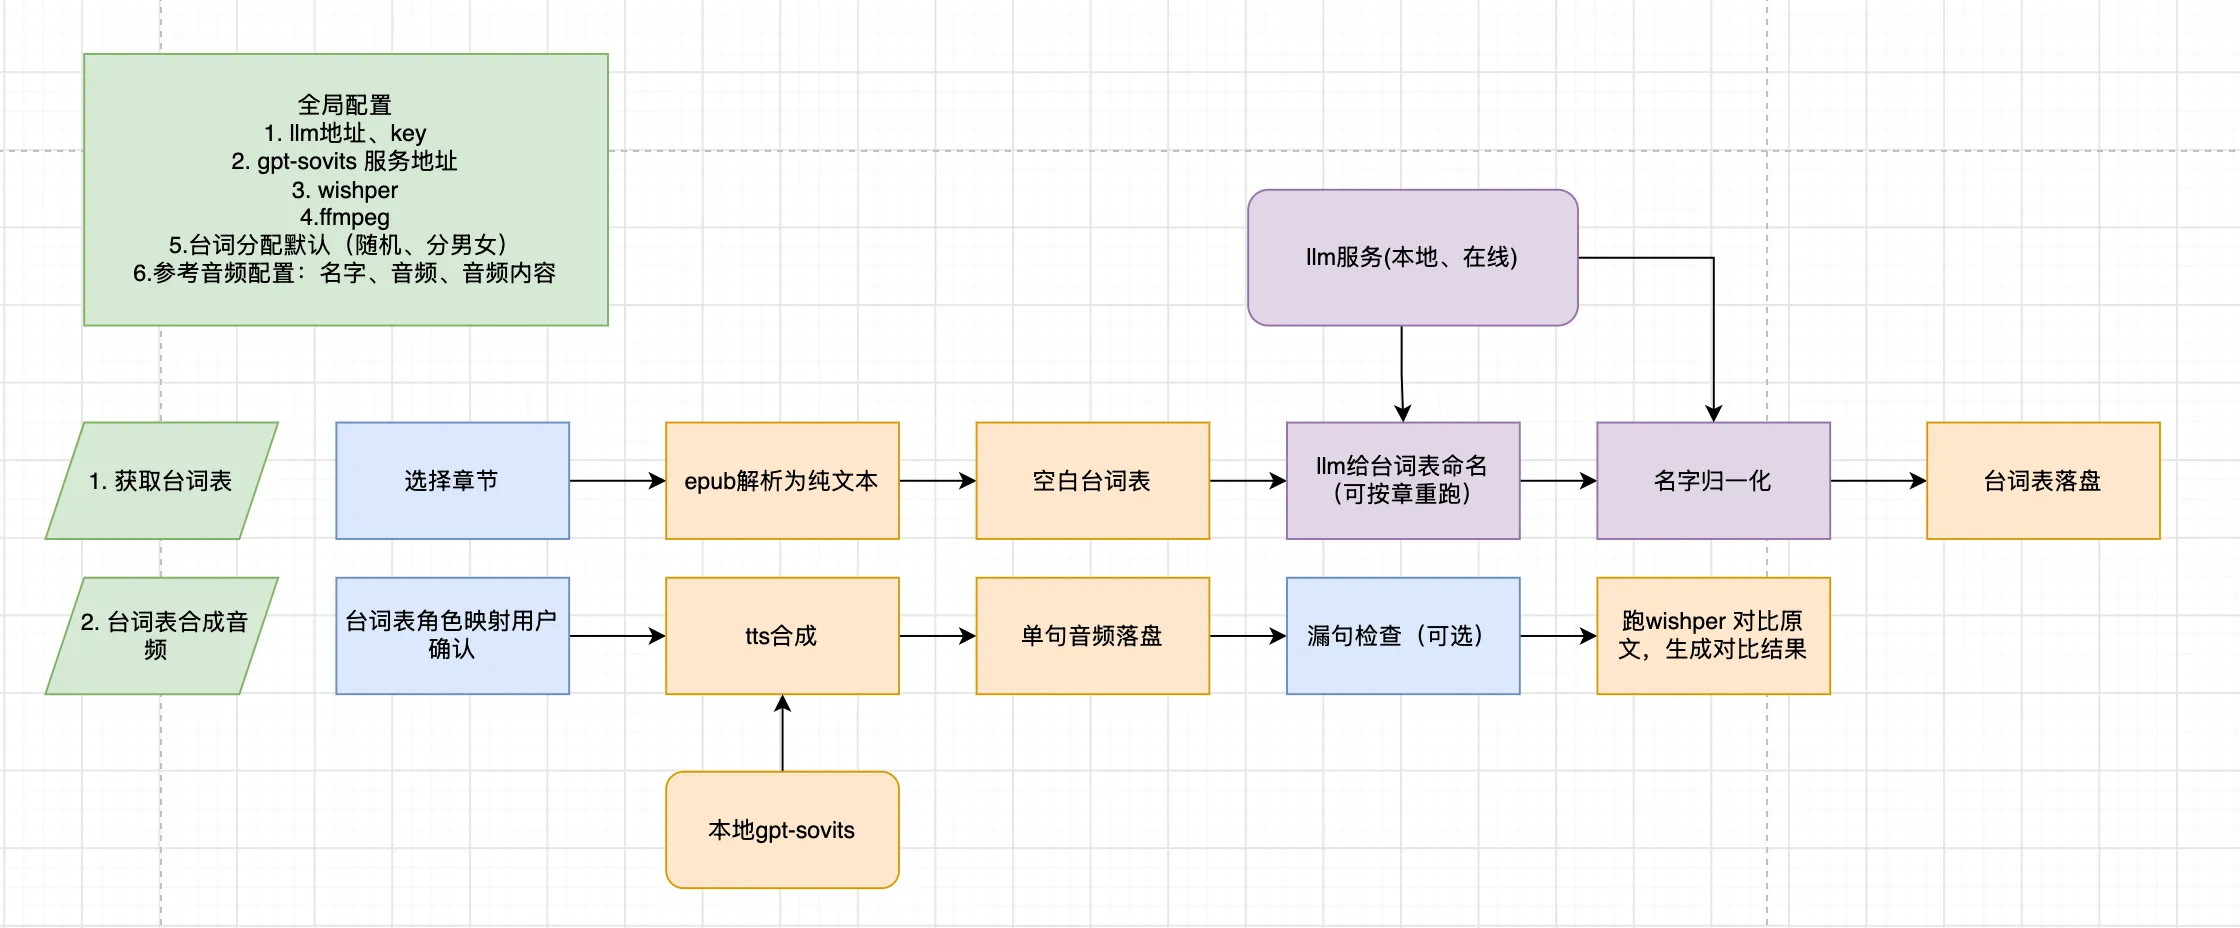
项目的整体架构和界面,都大致遵从如图所示的流程图,其中蓝色部分是用户操作、黄色部分是纯代码逻辑、紫色部分则是llm调用。
界面
页面功能
全局配置
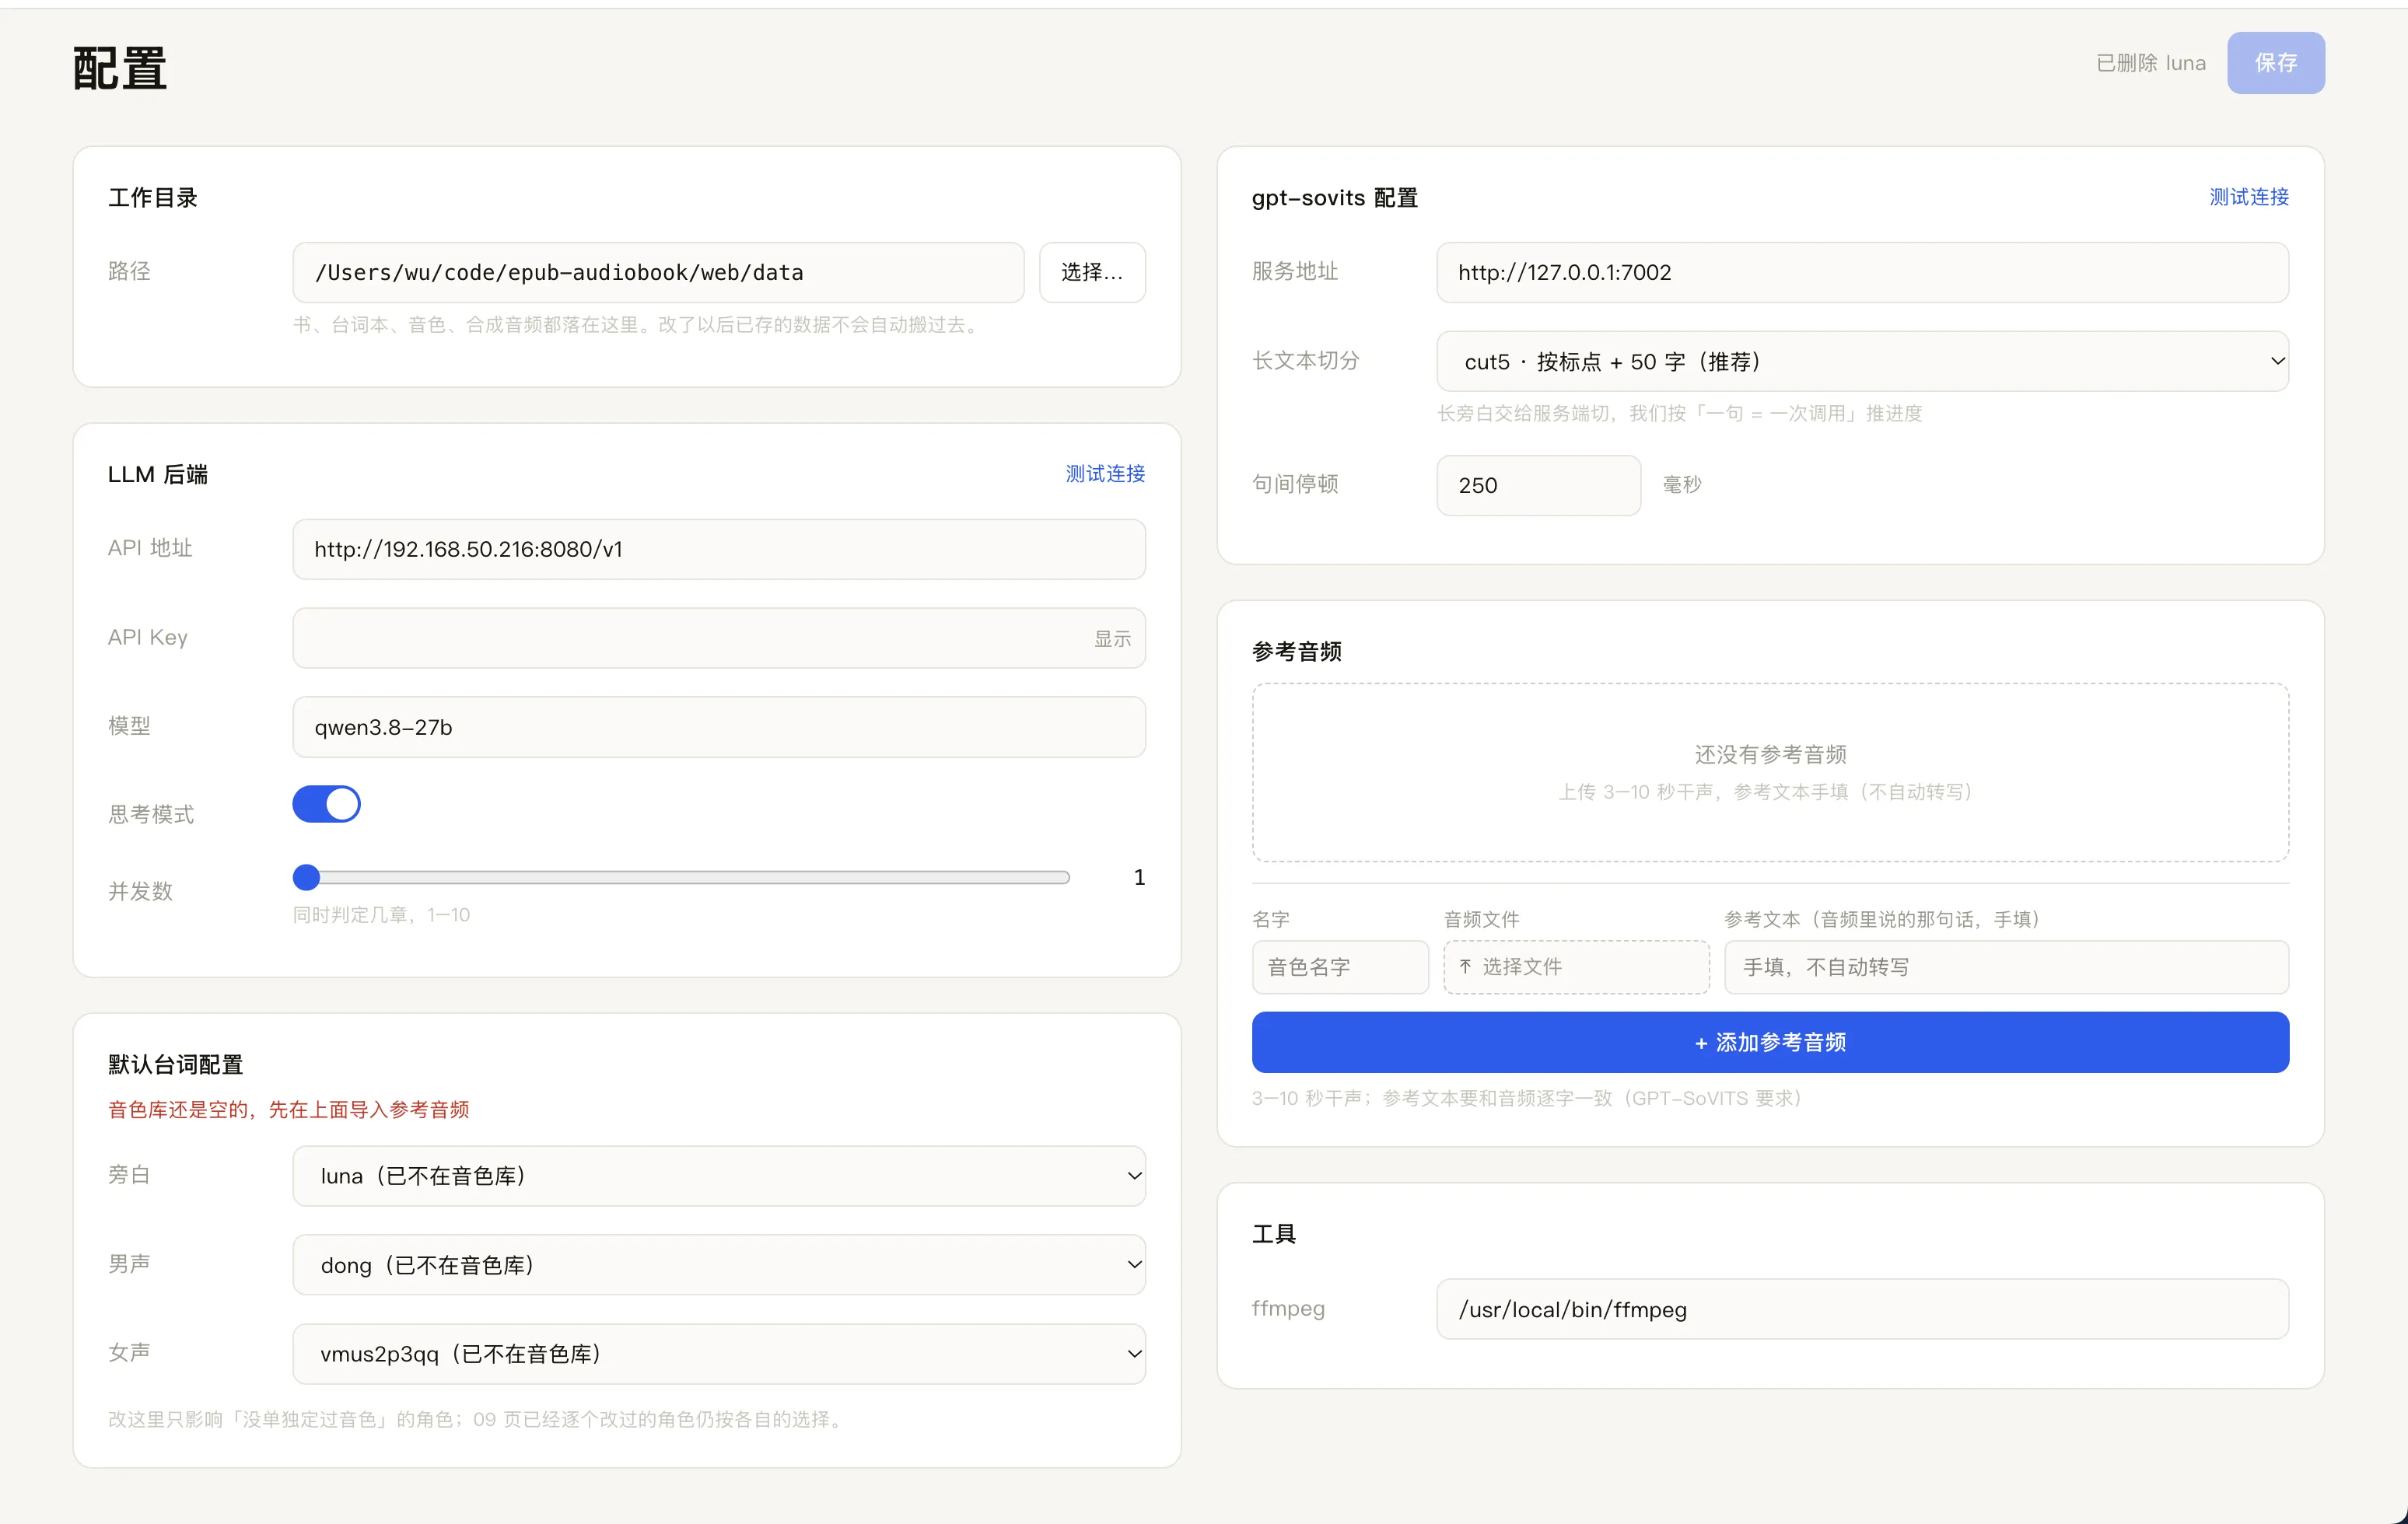
需要用户填写的有 llm配置(生成台词表用)、 gpt-sovits配置(合成音频用)、以及参考音频列表,其余可默认。
台词表获取
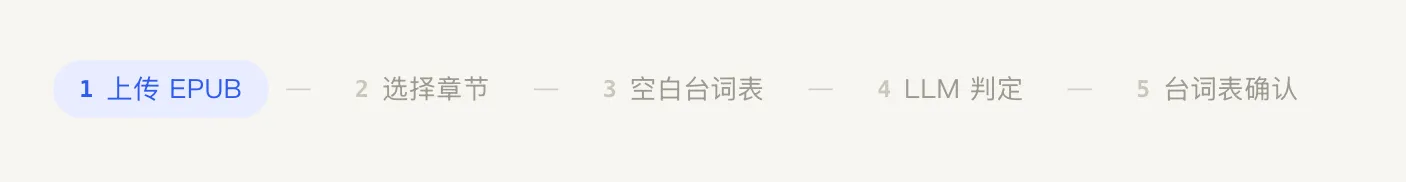
按照架构设计实现的五步流水线,跑完之后得到台词表,台词表可在“音频合成”tab查看到。
音频合成
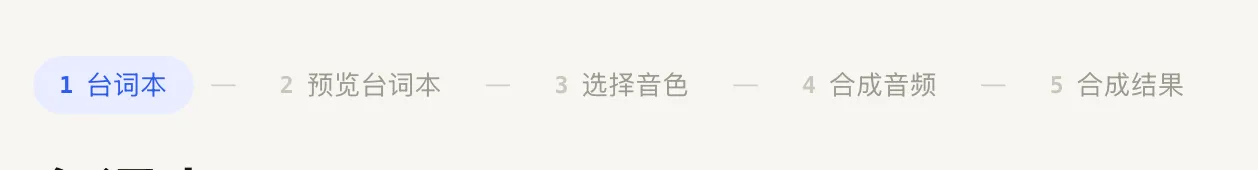
按照架构设计、实现的五步流水线,在第四步开始后,会在“音频查看”处看到这条任务,支持断点续跑。
上一篇 从今天开始开始写博客了
下一篇 (没有更晚的文章)